题目:
章登元:UAV VLN × WAM---从语言导航到预测式世界动作模型
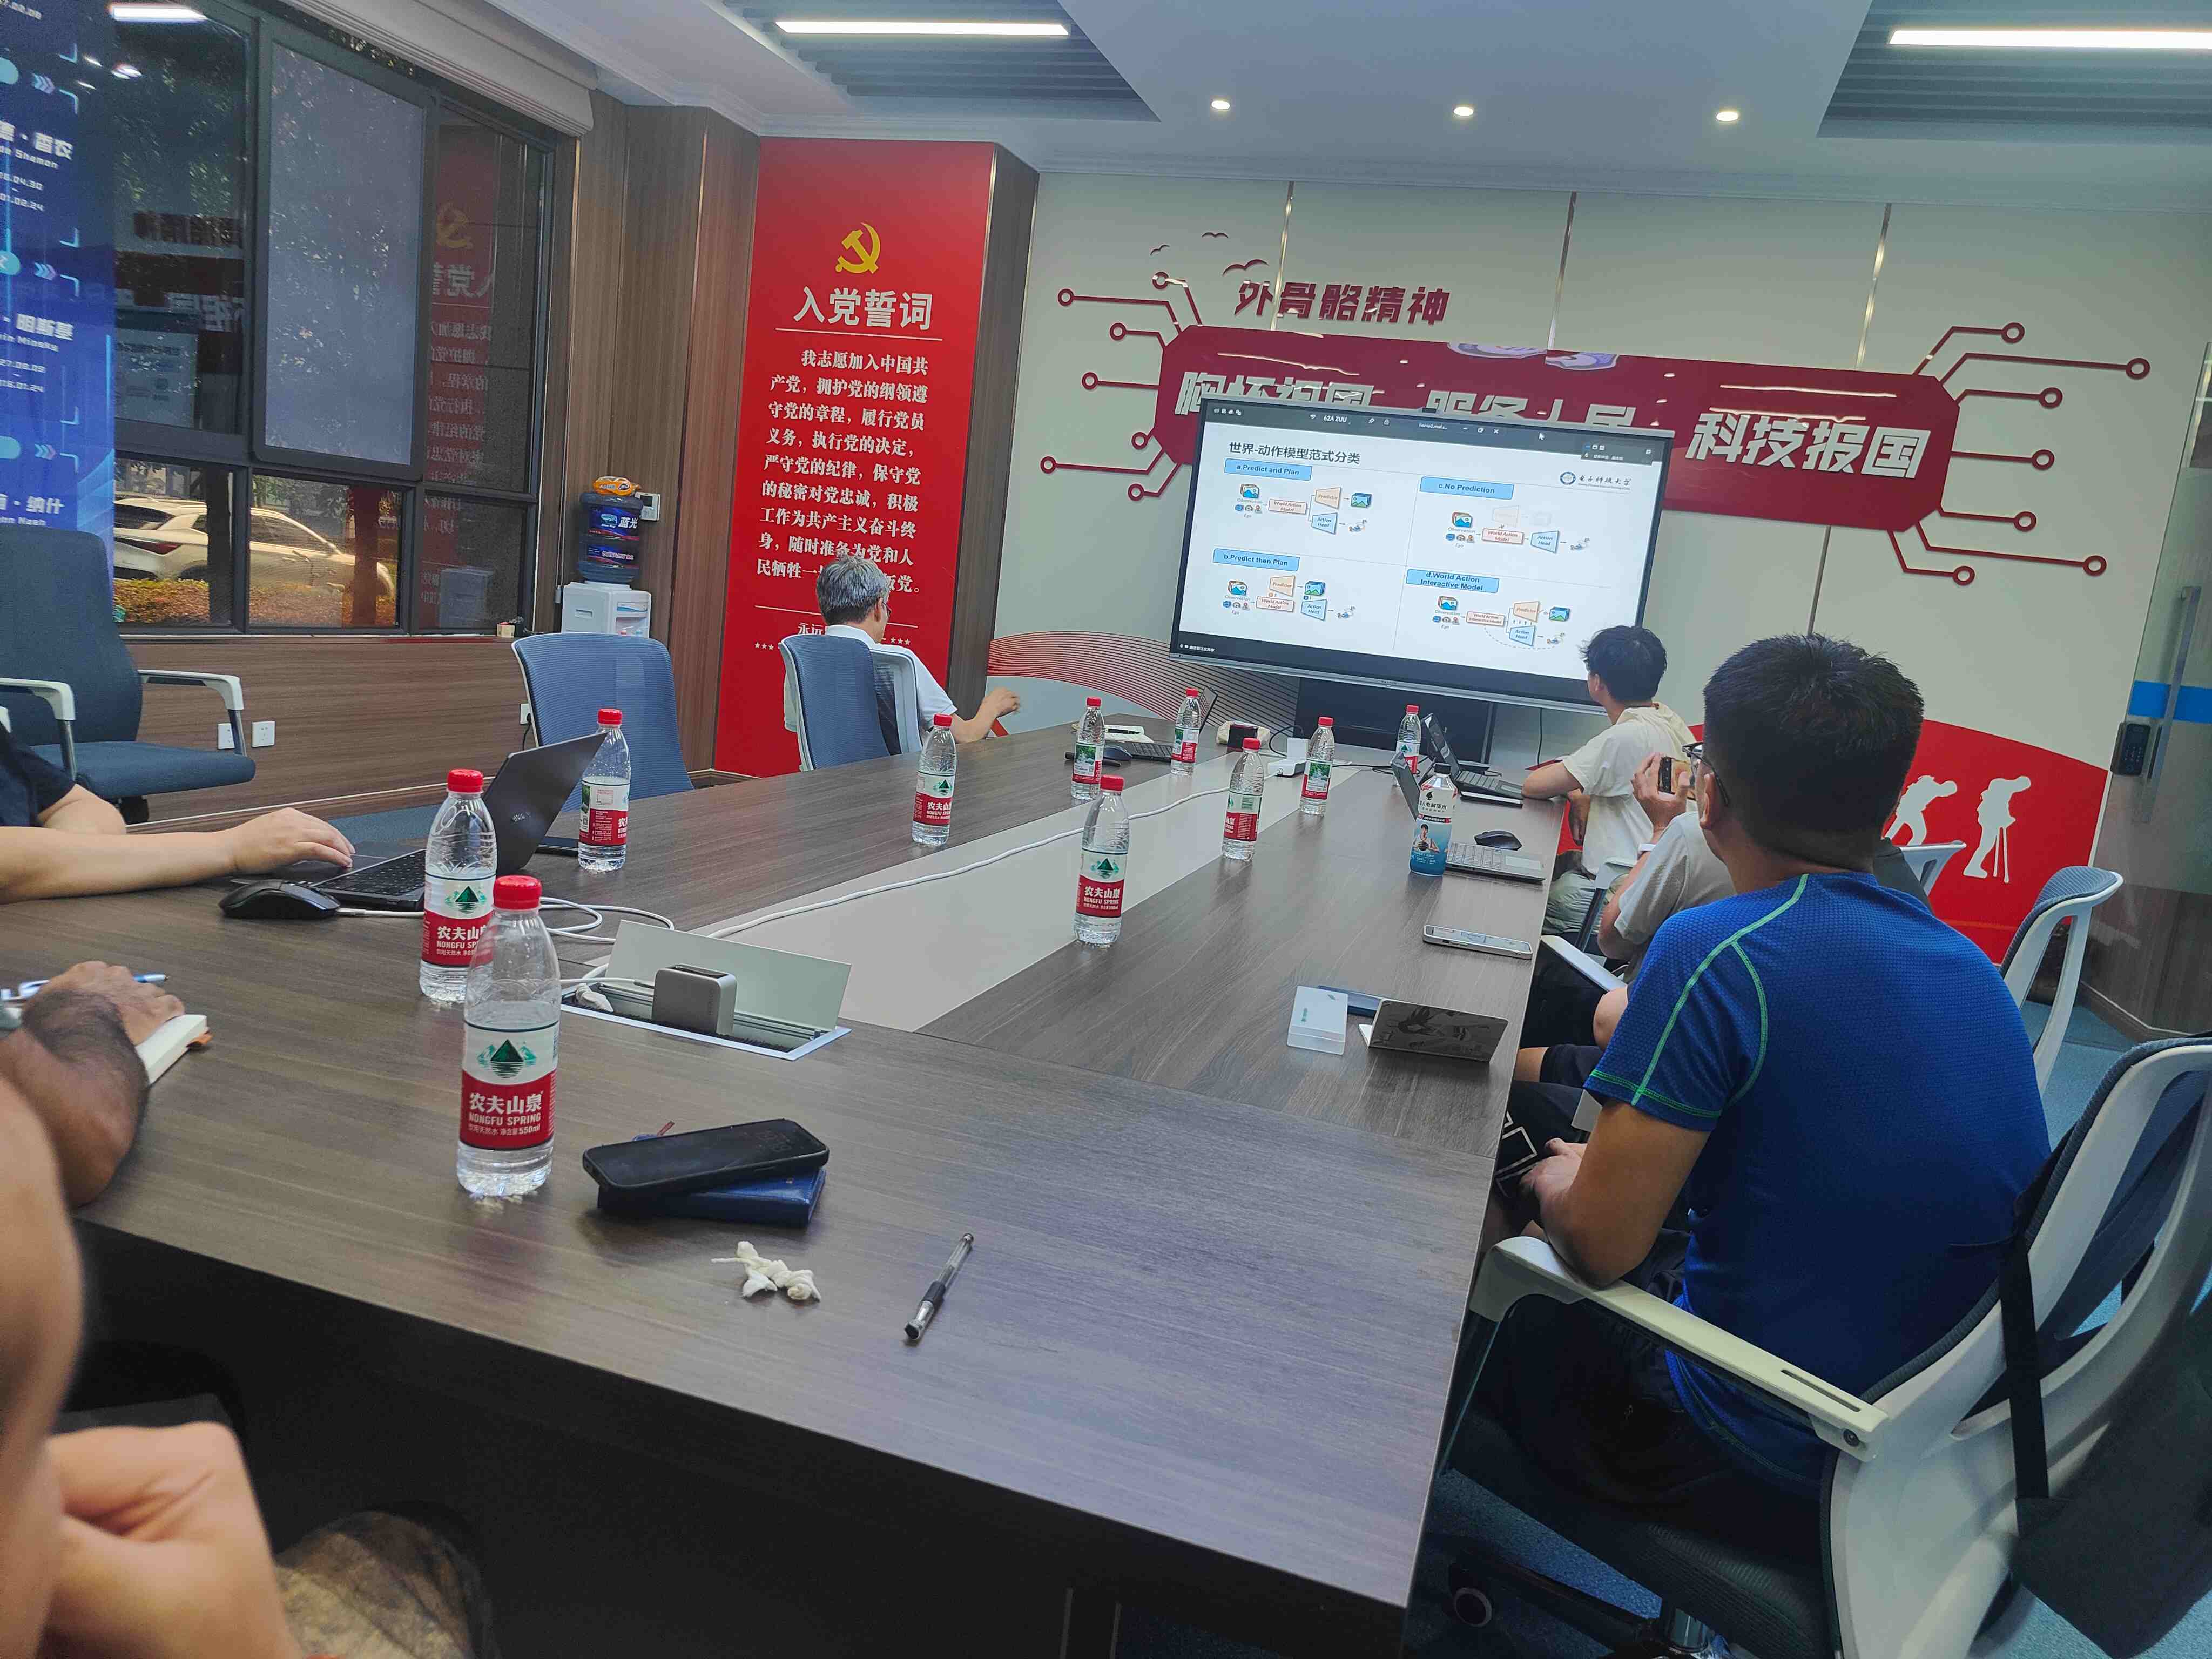
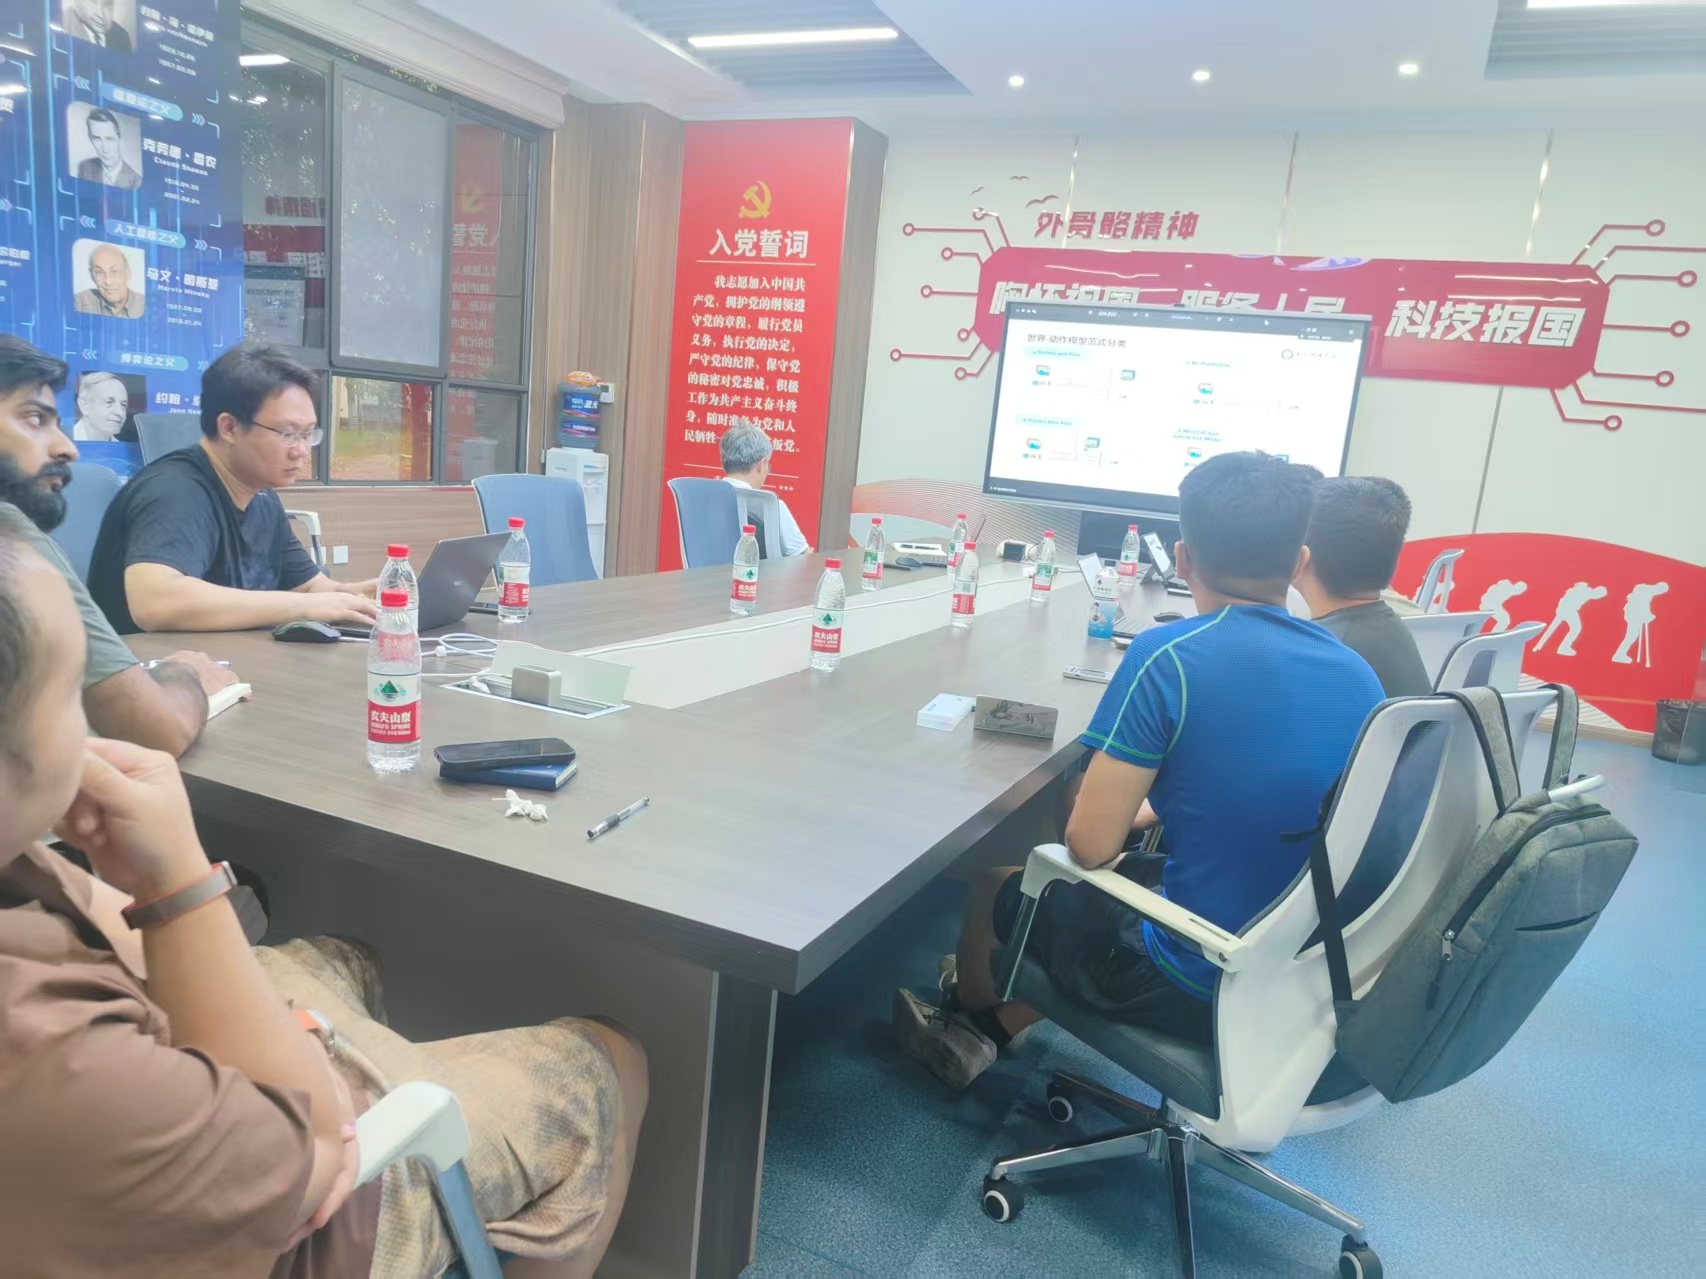
唐浩智:世界-动作模型范式梳理与代表性工作分析
摘要:本次技术分享围绕无人机视觉语言导航(VLN)与世界动作模型(World Action Model)展开。会议梳理了无人机导航从规则驱动、端到端学习到大模型驱动的发展过程,重点介绍了 Predict and Plan、Predict then Plan、No Prediction at Inference 以及 World Action Interaction 四类世界动作模型技术范式,并结合典型工作分析了未来预测与动作规划之间的关系。同时,围绕模型端侧部署、计算效率、世界模型与视觉语言模型融合以及因果一致性验证等问题进行了交流讨论。
无人机视觉语言导航旨在利用自然语言、视觉感知和空间信息实现复杂环境下的自主导航。随着视觉语言大模型的发展,无人机导航逐渐由传统的地图、规则和里程计驱动方式,向大模型直接理解任务指令并完成决策规划的方向演进。会议介绍了 OpenUAV、FlightGPT 和 World V 等代表性工作。其中,World V 通过视频生成模型预测未来环境状态,并结合动作解码器生成飞行轨迹,使模型能够根据未来场景变化提前调整决策。
在世界动作模型方面,会议重点梳理了四种技术路线。Predict and Plan 采用共享特征分别完成未来场景预测和轨迹规划;Predict then Plan 先生成未来场景,再基于预测结果完成动作规划;Fast WAM 则表明,未来预测在训练阶段能够有效增强模型的环境理解能力,而推理阶段可以省略显式视频生成,从而降低计算开销;World Action Interaction 进一步引入世界状态与动作之间的双向交互,通过多轮预测与动作修正提升轨迹规划效果。
交流环节中,与会人员围绕 World V 的性能来源、OpenUAV 对外部提示的依赖以及 DAW 模型交互轮数等问题进行了讨论。会议认为,未来状态预测能够为动作生成提供更强的决策依据,但预测与动作之间的交互并非越多越好,过多迭代可能引入额外噪声。同时,随着模型规模不断扩大,如何实现轻量化、低延迟端侧部署,并进一步融合 VLM 的语义理解能力与 World Model 的环境预测能力,将成为无人机具身智能的重要研究方向。
报告人:唐浩智、章登元
 联系电话
028-61830850
邮箱:
zjlhbj@uestc.edu.cn
地址:
四川省成都市高新西区西源大道2006号
电子科技大学清水河校区创新中心
版权所有©2020 人机智能技术与系统教育部工程研究中心 蜀ICP备2022017640号-1 公网安备 52032102000193号